Claude 搜索热度是 OpenAI 的 13 倍?开发者为什么都在用 Claude
10 月 16 日,我在 Google Trends 上拉了一组数据,结果有点意外。
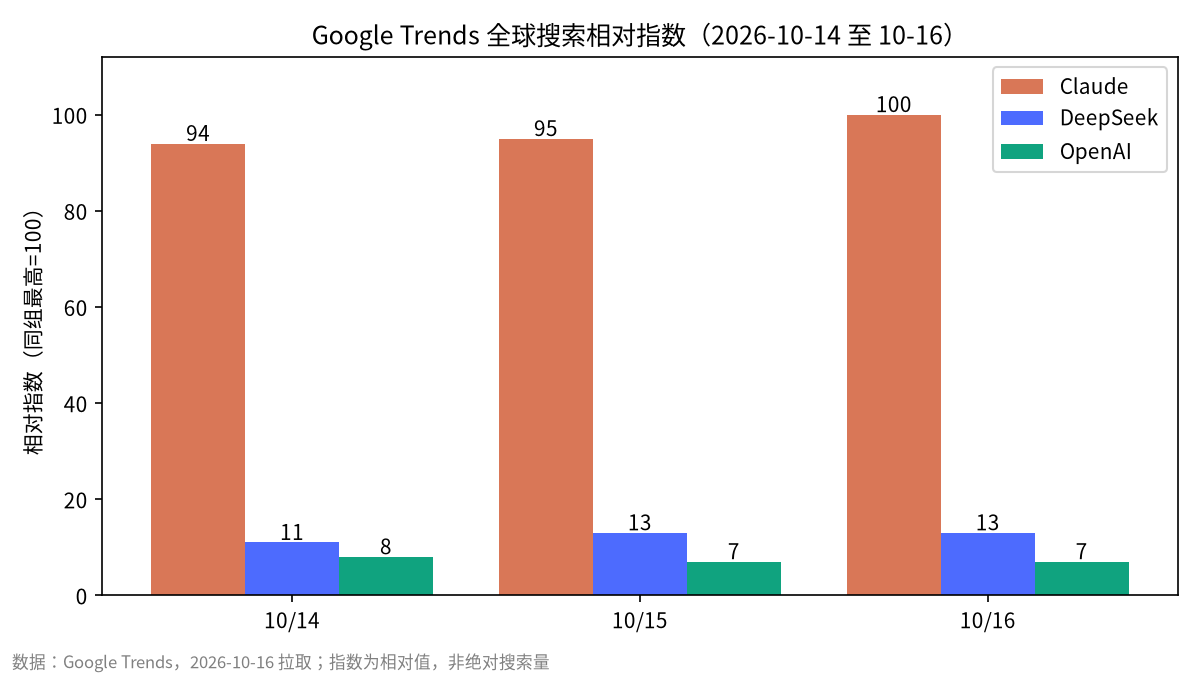
全球范围内,把「Claude」「OpenAI」「DeepSeek」三个词放在一起比较,近三天 Claude 的相对指数是 94、95、100,OpenAI 只有 8、7、7,DeepSeek 是 11、13、13。
粗略算一下,Claude 大约是 OpenAI 的 13 倍。
先把数据读对
这组数字很好看,但有三点要先说清楚。
第一,Google Trends 给的是相对指数,不是搜索次数。同一组对比里最高的点记为 100,其余按比例换算。
第二,比的是「OpenAI」这个公司名,不是「ChatGPT」。很多人直接搜产品名,所以这组数据不能得出「Claude 用户是 ChatGPT 的 13 倍」这种结论。
第三,「Claude」本身是个常见人名,也有非 AI 的含义(比如法语名、人名、品牌)。指数里一定混着一部分和 AI 无关的搜索。
所以更稳妥的说法是:Claude 这个词的搜索关注度明显在高位,而且关联词几乎都指向 AI 产品。
同期 Claude 的上升关联词包括:claude fable 5.1、claude opus 5、claude startup program,以及 kimi k3。前三个都是 Anthropic 的产品或项目名,这说明热度主体确实来自 AI。
原因一:模型发布节奏很密
过去四个月,Anthropic 几乎每个月都有一次大发布:
- 6 月 9 日:Claude Fable 5 发布,Anthropic 称其为第五代模型,面向「持续数天的复杂异步任务」。(Anthropic)
- 7 月 24 日:Claude Opus 5 发布,官方定位是「接近 Fable 5 的能力,价格减半」,主打日常办公和编程。(Anthropic、Reuters)
- 9 月 1 日:Claude Fable 5.1 发布,缓存读取价格降低 75%。官方估算典型任务成本降约 25%,高度 agent 化的任务最多降约 45%。(Anthropic)
- 9 月 22 日:Claude Opus 5.5 发布,官方称大多数任务达到 Fable 5.1 的水平,运行成本比 Opus 5 低 40%。(Anthropic、文档)
每一次发布都会带来一波「XX 怎么用」「XX 和 GPT 比怎么样」的搜索。新模型名不断出现在上升词里,本身就是热度的来源。
原因二:编程和 agent,是 Claude 的主场
开发者用 Claude,主要不是为了聊天,而是为了让它干活。
Anthropic 对 Opus 5 的描述是「为长时间、多步骤工作打造的 agent 编程模型」。官方数据显示,它在 Frontier-Bench v0.1 上的表现是 Opus 4.8 的两倍多,单任务成本更低。(Anthropic)
Opus 5.5 更进一步。按 Anthropic 公布的数据:
- 在衡量「代码改动能否被合并」的 FrontierCode 上,默认档位得分 54.6%,高于 GPT-6 Astra 的最高分 53.3%,单任务成本约为后者的五分之一;
- 一位早期测试者用它审计并修复 20 万行代码库,不到 3 小时完成,而 Opus 5 用了 20 多个小时。
(以上均来自 Anthropic 官方发布,属于厂商自测,Anthropic 自己也承认「在这个能力水平上,基准分差已经不太能代表真实差距」。)
还有一个容易被忽视的点:整个家族都是 1M 上下文、128K 输出。从 Haiku 5.5 到 Fable 5.1 都是如此。(Claude 文档)
对写代码的人来说,这意味着可以把整个项目塞进去,让模型自己翻、自己改、自己跑测试。
我自己的体会也类似:模型的「单次回答」质量差距已经不大,真正拉开差距的是它能不能连续干几个小时活而不跑偏。关于这一点,我在《AI 编程的杠杆》里写过更多,这里不展开。
原因三:价格分层清楚,选型简单
目前的 Claude 模型价格(每百万 token,输入/输出,美元):
| 模型 | 价格 | 适合场景 |
|---|---|---|
| Fable 5.1 | $10 / $50 | 最难的推理和长周期 agent 任务 |
| Opus 5.5 | $4 / $20 | 大多数任务的默认选择 |
| Sonnet 5.5 | $2 / $10 | 性价比 |
| Haiku 5.5 | 起步 $0.10 / $0.50 | 最快、最便宜 |
来源:Claude 文档。官方建议是「大多数工作先从 Opus 5.5 开始」。
对于一个想接 API 的开发者来说,这种「先用默认,不够再升级」的选型逻辑,比研究一堆命名混乱的版本要省心得多。
中文用户的门槛
说完优点,得说现实。
Claude 官方不对中国大陆提供服务。中国大陆不在 Anthropic 的支持地区列表里;2025 年 9 月,Anthropic 还进一步限制了由中国实体控股的公司使用其服务。(Anthropic)
这意味着:注册、付费、网络,每一步都可能卡住。通过非官方渠道「转售」的账号和 API,也存在封号和数据安全风险,我不建议在重要项目里依赖。
Anthropic 和中国 AI 圈的关系还有另一层张力,可以看我之前写的《Anthropic 蒸馏争议》,这里不重复。
用不了 Claude,怎么办
几个思路,按我自己的优先级排:
1. 海外合规用户:走云平台。 Claude 模型同时上架了 Amazon Bedrock、Google Cloud、Microsoft Foundry。(Claude 文档)如果你的公司本来就有海外云账号,这是最稳的路径。
2. 国内用户:用国产模型替代。 这次 Claude 的上升关联词里出现了 kimi k3,DeepSeek 的 V4 系列版本词也在涨。国产模型在编程和 agent 场景上的差距正在缩小,而且通常有更友好的价格和国内网络。具体怎么选,我准备单独写一篇对比。
3. 把工作流做成「模型无关」。 这是我最推荐的。用支持多模型切换的工具,把提示词、工具调用、测试流程沉淀下来。今天用 Claude,明天换成别的,流程不用重写。
模型会一直换代,真正值钱的是你的工作流。
小结
- Google Trends 上,Claude 的相对搜索指数近三天显著高于 OpenAI 和 DeepSeek,但这是相对值,且「Claude」一词含有非 AI 噪音,别过度解读。
- 热度背后是密集的模型发布(Fable 5 → Opus 5 → Fable 5.1 → Opus 5.5)和在编程、agent 场景上的持续投入。
- 中文用户的主要障碍是地区限制。与其冒风险找渠道,不如用国产模型并把工作流做成模型无关。
本文数据来自 Google Trends(2026-10-16 拉取)及 Anthropic 官方发布、Reuters 报道;基准测试数据均为厂商自测。不构成任何投资建议。